

Programming, graphics, games, media, C++, Windows, Internet and more...
Ten artykuł został oryginalnie opublikowany w numerze 4/2013 (11) magazynu Programista.
Choć języki wysokiego poziomu – skryptowe, interpretowane czy wykonywane w wirtualnej maszynie – mają wiele zalet i są najlepszym wyborem w licznych zastosowaniach, to niekiedy potrzebujemy napisać kod jak najbardziej wydajny. Do tego nie wystarczy zastosować język natywny taki jak C++. Dopiero pewna dawka wiedzy i znajomość dobrych praktyk pozwoli wycisnąć ze sprzętu maksimum mocy obliczeniowej.
C++ to język niezwykły – skomplikowany, trudny do opanowania, w niektórych kwestiach kontrowersyjny. W wielu zastosowaniach – szczególnie tam, gdzie liczy się wydajność, np. w programowaniu gier – jest jednak często najlepszym albo wręcz jedynym wyborem. Dzieje się tak, ponieważ posiada on unikatową cechę, przez którą stanowi swego rodzaju kompromis. Jest wysokopoziomowy – pozwala na programowanie obiektowe, a także wygodne używanie lub tworzenie własnych typów i struktur danych (np. wektory, łańcuchy znaków, kontenery STL). Równocześnie jest na tyle niskopoziomowy, że daje w pewnym sensie dostęp do samego sprzętu, czy raczej do systemu operacyjnego – na drodze nie staje tu żadna wirtualna maszyna ani framework. Alokacją i zwalnianiem pamięci musimy zarządzać sami, ale dzięki temu nie działa za nas żaden garbage collector, który robiłby to po swojemu, w nieprzewidywalnych momentach. Ponadto właśnie do C++ (oraz do C, z którym jest częściowo kompatybilny wstecz) istnieje ogromna liczba bibliotek i dostępne są kompilatory na różne platformy.
W pewnym sensie można nawet powiedzieć, że kod natywny wraca do łask. Mimo że oprogramowanie staje się coraz bardziej skomplikowane, a sprzęt coraz szybszy, nadal potrzebujemy w naszych programach wydajnego kodu. Niektórzy powtarzają, że szybszy procesor lub więcej pamięci RAM jest tańsze, niż czas pracy dobrego programisty. Co jednak, jeśli raz napisany program ma pracować przez wiele lat lub zostać zainstalowany na milionach maszyn? Wydajność liczy się zarówno w klastrach obliczeniowych i centrach danych, w których koszty zasilania i chłodzenia mogą być ogromne, jak i w tych najmniejszych urządzeniach (jak smartfony i tablety), w których z kolei chcemy osiągnąć jak najdłuższy czas pracy na baterii. Ponadto istnieją zastosowania, w których kod musi działać z określoną szybkością bez żadnych kompromisów. Chodzi o programy przetwarzające dane w czasie rzeczywistym, takie jak gry (w których spadek liczby FPS – klatek na sekundę – powoduje utratę efektu płynnej animacji i nieprzyjemne „klatkowanie”) czy też przetwarzanie strumieni mediów w czasie rzeczywistym z określonym bitrate'em. Nie zawsze mamy też możliwość podania dowolnie dużych wymagań sprzętowych. Przykładowo, konsole do gier mają z góry określoną częstotliwość pracy procesora i ilość pamięci RAM. Nawet od peceta nie możemy wymagać, by był wyposażony w najnowocześniejsze komponenty, jeśli piszemy np. prostą grę typu casual, a nie nową wersję Crysisa.
Programowanie obiektowe zdaje się być lekiem na bolączki programistów i zespołów, dla których pisanie rozbudowanych systemów w sposób strukturalny – czyli ten „staroświecki” – byłoby zbyt trudne. W programowaniu obiektowym kod składa się z klas, a te nie tylko grupują razem dane (pola) i procedury, które na tych danych operują (metody), ale przede wszystkim stanowią abstrakcję pojęć z rzeczywistego świata czy z dziedziny problemu, której dotyczy program. Ponadto klasy powinny być (przynajmniej w teorii) jak najbardziej niezależne i nadające się do ponownego użycia w innych miejscach.
Programowanie obiektowe można jednak rozumieć dwojako – bardziej od strony koncepcyjnej, myśląc o filozofii, jaka stoi za jego elementami, bądź też od strony technicznej – traktując je jako mechanizm języka programowania i stosując go dla wygody. Równocześnie warto być świadomym, jak to wszystko działa „pod spodem”, wynikających z tego cech i ograniczeń. Stosując wyłącznie to pierwsze podejście można zbyt daleko odejść od poziomu, na jakim programista powinien pozostać chcąc pisać wydajny kod.
Co jest więc rozwiązaniem? Nieco inny sposób myślenia proponują zwolennicy podejścia nazwanego Data-Oriented Design (DOD) – projektowania zorientowanego na dane. To pojęcie stało się popularne w ostatnich latach szczególnie wśród programistów gier. Oznacza ono skupienie się podczas projektowania i pisania kodu na danych, jakie będą przechowywane – ich ułożeniu w pamięci, zaprojektowaniu odpowiednich struktur danych, a dopiero w następnej kolejności na algorytmach, które będą na tych danych operowały. To może się wydawać powrotem do dawnej idei programowania strukturalnego, ale tak naprawdę wcale nie wyklucza użycia klas i wszelkich dobrodziejstw programowania obiektowego. Chodzi tutaj bardziej o sposób myślenia, który pozostaje bliżej sprzętu i wykorzystuje dostępne mechanizmy języka programowania do stworzenia kodu, który będzie nie tylko „elegancki”, ale też prosty i wydajny.
Spójrz na Rysunek 1. Przedstawia on w symboliczny sposób ułożenie danych w pamięci. Po lewej stronie pokazane są struktury rozrzucone daleko od siebie i powiązane wskaźnikami. Tak dzieje się, kiedy używamy wielu małych obiektów różnych klas, które wzajemnie odwołują się do siebie. Kod napisany z takim podejściem może być niewydajny z dwóch powodów. Pierwszym jest częste nietrafianie w pamięć podręczną podczas przechodzenia po takich danych z powodu „skakania” po wskaźnikach. Jest o tym dokładniej mowa poniżej.
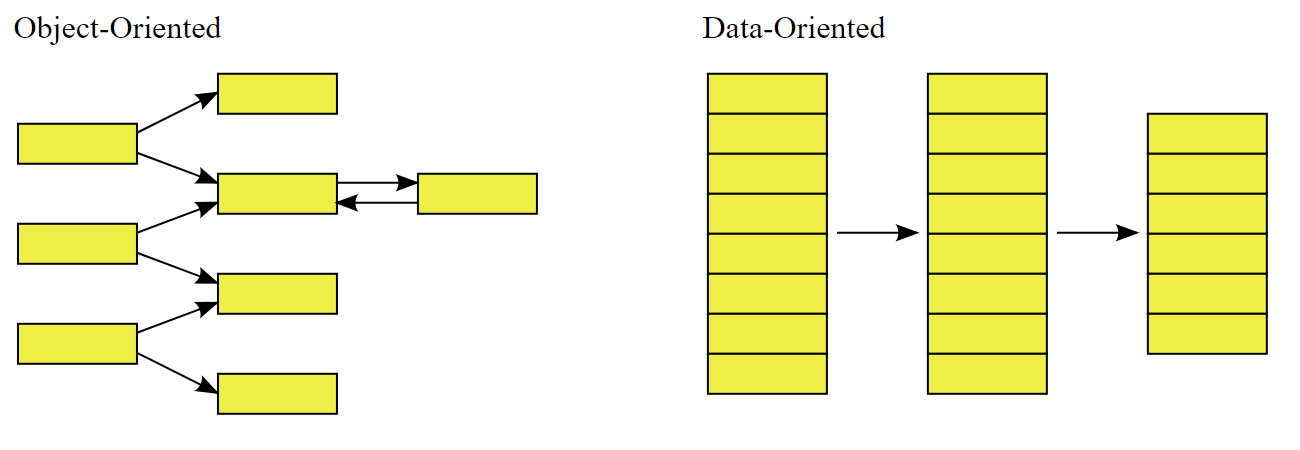
Drugi powód to trudność w zrównolegleniu kodu operującego na takich obiektach. Jeśli do dyspozycji mamy publiczne metody klas (często wirtualne) i naszym założeniem jest, aby nie wiedzieć, co dzieje się w ich wnętrzu (oraz we wnętrzu wszystkich klas pochodnych), z założenia nie możemy też bezpiecznie wykonywać ich wielowątkowo. Nie wiemy bowiem, do jakich innych obiektów odwołują się one w czasie tych operacji. Użycie wątków natomiast wiąże się często z zabezpieczeniem wspólnych danych muteksami (sekcjami krytycznymi), które właściwie serializują kod, nie pozwalając mu na wykonywanie się w pełni równolegle.
Z kolei prawa część rysunku przedstawia koncepcję regularnej struktury danych (np. tablicy), którą przetwarzamy, wykonując na niej kolejne operacje – np. sortowanie, zaktualizowanie określonych pól, usuwanie elementów czy zamianę każdego elementu na inną postać. Jeśli dane są „przezroczyste” i wiemy dokładnie, jaką operację chcemy wykonać oraz jej wykonanie na każdym elemencie kolekcji jest niezależne od pozostałych i od całej reszty programu, wówczas możemy łatwo taki algorytm zrównoleglić – np. rozdzielając zakres elementów do przetworzenia między wątki.
Ślepe podążanie za ideą programowania obiektowego niesie ze sobą także inne pułapki. Niektórzy mają odruch zamykania każdej używanej funkcjonalności, np. biblioteki, we własną otoczkę (ang. wrapper), która miałaby np. uprościć jej interfejs albo uczynić go (subiektywnie) bardziej eleganckim. Taka dodatkowa warstwa – szczególnie kiedy wprowadza jakąś własną logikę czy używa metod wirtualnych, powoduje dodatkowy narzut czasowy. Dlatego w zamian proponuję wyrobić sobie odruch zastanowienia się za każdym razem, czy w naszym konkretnym przypadku nie wystarczy użyć pewnych funkcji i klas bezpośrednio, bez wprowadzania nowej warstwy abstrakcji? Podobnie zdaje się działać tendencja do czynienia wszystkiego jak najbardziej ogólnym i uniwersalnym. Zdefiniować interfejs z samymi metodami wirtualnymi i obiecać sobie, że możemy bez jego zmiany wymienić implementację na zupełnie inną to kusząca perspektywa, ale czy w tej chwili i w tym miejscu kodu naprawdę tego potrzebujemy? Również wzorce projektowe bywają nadużywane, jako gotowe rozwiązania mające nieraz zastąpić głębsze zastanowienie się nad pisanym kodem. Tymczasem okazuje się, że często proste rozwiązania są najlepsze. Jeśli pisząc kod postaramy się wyrazić jak najbardziej bezpośrednio to, jakie dane program ma przechowywać i jakie operacje na tych danych wykonywać, wówczas będzie on prosty, elegancki, czytelny i równocześnie wydajny. To przeczy popularnemu poglądowi, jakoby optymalizacja polegała na czynieniu kodu skomplikowanym i nieczytelnym.
Mogłoby się wydawać, że każda instrukcja w jednym cyklu procesora pobiera jakieś dane spod podanych adresów w pamięci RAM, wykonuje na nich określoną operację (np. dodawanie), po czym zapisuje wynik z powrotem do pamięci. W praktyce nie jest to takie proste. Skomplikowane instrukcje CISC, z jakich składa się kod x86, są wewnątrz procesora tłumaczone na mikrokod i wykonywane w wielu krokach, które mogą trwać krócej lub dłużej. Sama operacja może być prosta, ale odczytanie lub zapisanie danych do pamięci zajmuje dodatkowy czas.
Kiedyś – w latach 80-tych – procesory faktycznie korzystały z pamięci RAM bezpośrednio i mogły przeprowadzać takie operacje w pojedynczych cyklach. Teraz niestety prędkość obliczeń, jakie jest w stanie wykonać procesor w określonym czasie wzrasta dużo szybciej, niż wydajność pamięci RAM. Ta przepaść wciąż się powiększa, a już teraz czas potrzebny na odczytanie jakiejś danej – choćby jednego bajtu – z pamięci operacyjnej współczesnego komputera trwa tyle czasu, ile kilkaset cykli obliczeniowych procesora! Pamiętajmy przy tym, że czym innym jest przepustowość (ang. bandwidth), czyli prędkość przesyłania danych (mierzona w bitach na sekundę), a czym innym opóźnienie (ang. latency), czyli czas potrzebny na dotarcie zamówionych danych do celu (mierzony w ułamkach sekund).
Konstruktorzy komputerów szukają oczywiście rozwiązań tego problemu. Z tego powodu powstał cache, czyli pamięć podręczna procesora przechowująca ostatnio używane dane, do której dostęp jest szybszy, niż do głównej pamięci RAM. Możemy mówić o całej hierarchii pamięci, która na kolejnych poziomach jest coraz bardziej pojemna, ale coraz wolniejsza. Pomówmy dla przykładu o procesorze pracującym z częstotliwością 3 GHz. Taki procesor jest w stanie – w pewnym przybliżeniu – wykonać 3 miliardy operacji na sekundę, a więc jedna prosta operacja (np. dodawanie) trwa ok. 0.33 ns. Jeśli czas dostępu do wartości w pamięci cache L1 wyniesie 1 ns, będzie to opóźnienie równoważne wykonaniu 3 instrukcji (3 cykli). Szacunkowe dane na temat hierarchii pamięci w takim przykładowym systemie komputerowym pokazuje Tabela 1.
| Rodzaj pamięci | Czas dostępu | Pojemność | |
|---|---|---|---|
| Rejestry procesora | 0,33 ns | 1 cykl | |
| Cache L1 | 1 ns | 3 cykle | 32 KB |
| Cache L2 | 4,7 ns | 14 cykli | 6 MB |
| RAM | 83 ns | 250 cykli | 8 GB |
| Dysk twardy | 15 ms | 45 mln cykli | 1 TB |
| Internet | 80 ms | 240 mln cykli | |
Tabela 1. Hierarchia pamięci
Pamięcią podręczną w typowym systemie komputerowym nie sterujemy bezpośrednio. Ona jest kontrolowana automatycznie, by przyspieszyć dostęp do ostatnio używanych danych. Jak wobec tego wykorzystać przyspieszenie, jakie ona oferuje? Do tego potrzebna jest znajomość podstaw jej działania. Podczas dostępu do nowych, nieużywanych wcześniej danych z pamięci RAM dane te są odczytywane i wykorzystane do obliczeń, ale trafiają też do pamięci cache. Nie są to pojedyncze bajty, ale cała tzw. linia o szerokości – przykładowo – 64 bajtów. Naraz odczytywana jest z pamięci RAM i zachowana w cache cała taka linia, tak że do czasu zastąpienia jej innymi danymi (cache ma przecież mniejszą pojemność, niż RAM, więc mieszczą się tam tylko ostatnio używane wpisy) dostęp do którychkolwiek z tych danych będzie szybki, ponieważ wystarczy sięgnąć do cache, a nie potrzeba dostępu do pamięci RAM. Nazywamy to cache hit – trafienie w pamięć podręczną. Przeciwieństwem jest cache miss – nietrafienie, które powoduje odwołanie do pamięci głównej i trwa o wiele dłużej.
Co to oznacza dla nas? Sposobem na wykorzystanie przyspieszenia, jakie daje pamięć podręczna, jest odpowiednie ułożenie danych w pamięci tak, aby dane często używane razem leżały tuż obok siebie. Wówczas istnieje duża szansa, że tak rozmieszczone wartości będą już w pamięci podręcznej w chwili, kiedy kod będzie chciał z nich skorzystać. Dlatego dobrą praktyką jest:
std::vector.Złą praktyką jest natomiast stosowanie wielu małych obiektów alokowanych oddzielnie i rozrzuconych po pamięci. Podobnie, wolne działanie właśnie z powodu częstego nietrafiania w cache można przypisać strukturom danych, których przechodzenie polega na „skakaniu” po wskaźnikach – jak listy łączone, drzewa i grafy.
Weźmy dla przykładu kolekcję obiektów, którą potrzebujemy w programie zbudować, a następnie przechowywać w pamięci, przechodzić w porządku posortowanym oraz szybko przeszukiwać. Aby elementy były posortowane, nasuwa nam się pomysł użycia jakiejś formy drzewa binarnego lub innej podobnej struktury, która będzie potrafiła utrzymać porządek elementów oraz znajdować je w czasie logarytmicznym – np. kontenery std::set czy std::map z STL. Tymczasem te struktury alokują każdy element dynamicznie ze sterty i łączą je wskaźnikami, co czyni budowanie takiej struktury oraz jej przechodzenie powolnym. Oczywiście złożoność asymptotyczna wyszukiwania jest tutaj dobra, natomiast czynnik stały – z opisanych wyżej powodów – może zdecydować o niskiej wydajności.
Czasami możemy znaleźć inne rozwiązanie, wcale nie gorsze pod względem złożoności teoretycznej, a działające szybciej w praktyce. Jeśli tą strukturę budujemy raz i potem nie potrzebujemy już wstawiać ani usuwać z niej elementów, zastosujmy zwykłą tablicę. Po dodaniu wszystkich elementów wystarczy jednokrotnie ją posortować. Potem w takiej posortowanej tablicy można znajdować elementy w czasie logarytmicznym za pomocą wyszukiwania binarnego. Jej przechodzenie zaś będzie dużo szybsze dzięki dobremu wykorzystaniu pamięci podręcznej, ponieważ kolejne elementy będą leżały w pamięci obok siebie.
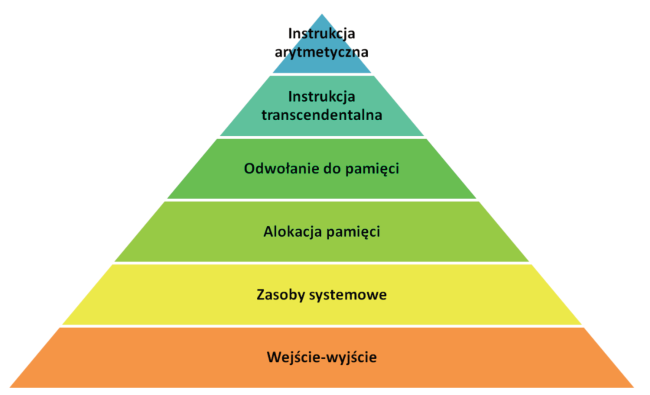
Opisaną wyżej hierarchię pamięci, w której odwołanie do każdego niższego poziomu działa wolniej od poprzedniego, można rozszerzyć na innego rodzaju operacje. Tak jak w różnych dziedzinach nauki rysuje się piramidy (np. piramida potrzeb), wyobraźmy sobie „piramidę wydajności” – Rysunek 2. Nie jest to żaden ścisły podział, a tylko propozycja jednej z wielu możliwości rozrysowania pewnych wybranych operacji. Operacja na każdym niższym poziomie jest o co najmniej jeden rząd wielkości wolniejsza, niż ta na wyższym. Dlatego chcąc pisać wydajny kod, należy być tego świadomym i w miarę możliwości unikać częstego wykonywania tych operacji z niższych poziomów. Pod poszczególnymi poziomami kryją się:
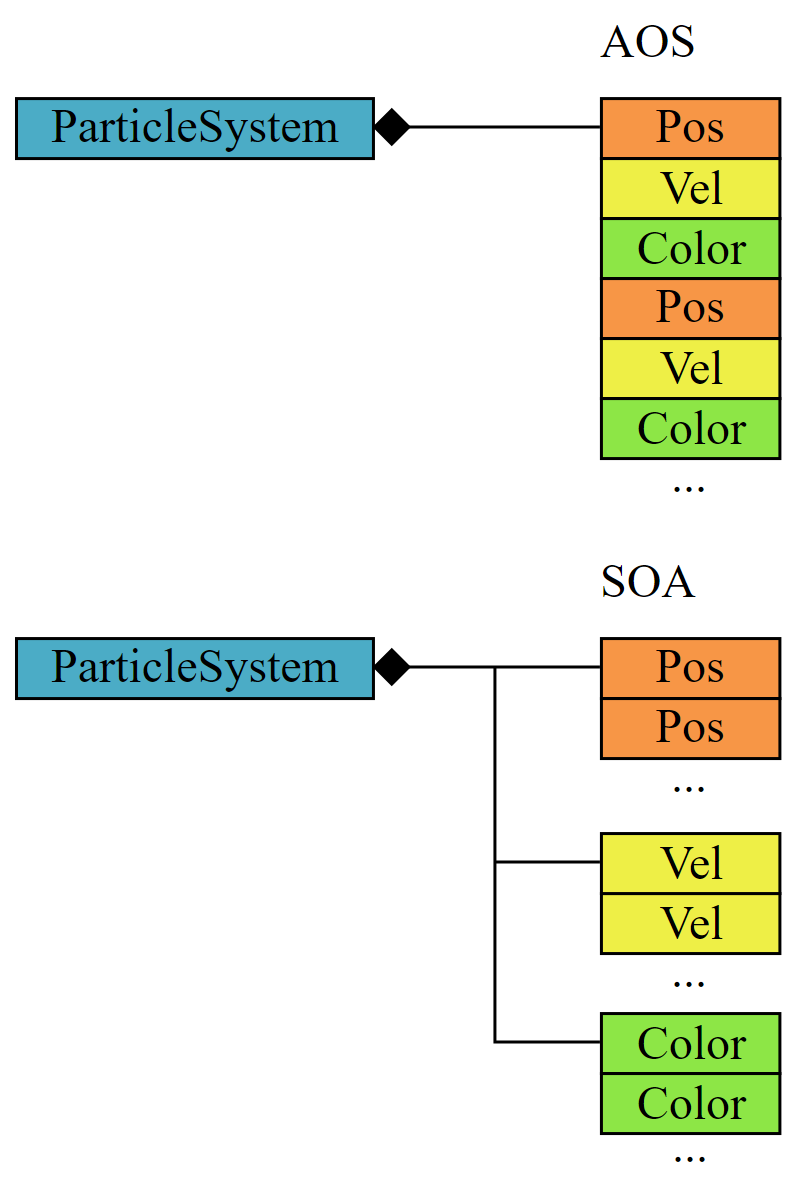
fread, fwrite dla pojedynczych bajtów.Popularnym efektem w grafice 3D są systemy cząsteczkowe (ang. particle system). Mówiąc w skrócie, ich działanie polega na przechowywaniu kolekcji cząsteczek – ich właściwości (jak aktualna pozycja, prędkość, kolor) oraz przeliczaniu i renderowaniu ich w każdej klatce animacji (czyli wiele razy na sekundę). Jak zapewne domyślasz się na podstawie wiedzy z poprzedniego rozdziału, struktur z cząsteczkami nie powinniśmy alokować dynamicznie jako osobne obiekty, ale przechowywać w tablicy – w ciągłym obszarze pamięci. Zobaczmy teraz, jak możemy zoptymalizować je jeszcze bardziej. Spójrz na Listing 1. Intuicyjne wydaje się podejście pokazane tu jako pierwsze i nazwane AOS – Array of Structures. Mamy tu zdefiniowaną strukturę, która reprezentuje pojedynczą cząsteczkę i opisuje wszystkie jej parametry. Następnie klasa odpowiedzialna za cały efekt cząsteczkowy przechowuje liczbę cząsteczek i wskaźnik do tablicy tych struktur.
Listing 1. AOS kontra SOA w systemie cząsteczkowym
// AOS - Array of Structures
struct Particle
{
    vec3 Position;
    vec3 Velocity;
    vec4 Color;
};

class ParticleSystem
{
    Particle* Particles;
    size_t Count;
};

// SOA - Structure of Arrays
class ParticleSystem
{
    vec3* Positions;
    vec3* Velocities;
    vec4* Colors;
    size_t Count;
};
Tymczasem możliwe jest inne podejście. Drugi przykład to SOA – Structure of Arrays. Tutaj mamy klasę efektu cząsteczkowego przechowującą bezpośrednio tablice zawierające poszczególne parametry kolejnych cząsteczek. Jest więc zdefiniowana tablica pozycji, prędkości, kolorów itd. – każda o tej samej liczbie elementów, równej liczbie cząsteczek. Takie podejście może – zależnie od konkretnego przypadku – okazać się wydajniejsze, jeśli grupuje dane według wzorca użycia i oddziela dane „gorące” – te które są aktualnie potrzebne i trafią do pamięci podręcznej, od danych „zimnych”. Tak będzie na przykład, kiedy chcemy przejść wszystkie cząsteczki i zaktualizować ich pozycje na podstawie prędkości. W drugim podejściu te dane leżą bliżej siebie w pamięci i nie są przeplecione z kolorem, który nie jest nam akurat potrzebny. Ułożenie tych danych pokazuje Rysunek 3.
Tworzenie wydajnego kodu nie dotyczy wyłącznie projektowania struktur danych i algorytmów na wysokim poziomie. Także pisząc już konkretne funkcje, możemy zrobić wiele, by uniknąć pułapek mogących niepotrzebnie pogorszyć wydajność. Język C++ wyposażony jest w wiele udogodnień, ale równocześnie daje nam wybór, czy chcemy z nich korzystać, czy może pisać zupełnie tak jak w C.
Dlatego w wielu przypadkach warto zrezygnować z używania i całkowicie wyłączyć niektóre możliwości, takie jak obsługa wyjątków czy RTTI. Choć to temat nieco kontrowersyjny, mechanizmom tym przypisuje się nieraz negatywny wpływ na wydajność kodu. Nie znaczy to, że są nic nie warte albo źle zaimplementowane. Można natomiast zastanowić się, czy w naszym programie są potrzebne i jeśli nie, wówczas warto wyłączyć je w opcjach kompilacji.
Nieprawdą jest powtarzany czasem pogląd, że nie jesteśmy w stanie napisać czegoś lepiej, niż to zrobili twórcy kompilatora, biblioteki standardowej czy innej popularnej i sprawdzonej biblioteki. Taki kod z pewnością został napisany przez świetnych programistów, ale my pisząc swój program, znamy konkretny przypadek, w którym potrzebujemy użyć jakiejś funkcjonalności – jego wymagania i ograniczenia. Dlatego identyfikacja typu obiektu w czasie wykonania, obsługa błędów i wiele innych czynności może być i nieraz jest implementowana lepiej we własnym zakresie, w sposób odpowiedni do potrzeb danego projektu. Najlepszym tego przykładem jest alokacja pamięci. Systemowy alokator jest dobry w takim sensie, w jakim dobry może być uniwersalny alokator. Jeśli jednak w jakimś miejscu programu potrzebujemy alokować obiekty o znanym, stałym rozmiarze i znamy górne ograniczenie na ich liczbę, to nie ma wątpliwości, że wydajniejszym rozwiązaniem będzie napisanie własnego alokatora opartego na przygotowanej wcześniej puli wolnych komórek (tzw. Free List).
Podobnie jest z biblioteką STL. To bardzo dobra biblioteka. Można nawet powiedzieć, że jest nastawiona na wydajność nawet kosztem bezpieczeństwa, ponieważ np. nie sprawdza przekroczenia zakresu podczas odwołania do elementu wektora operatorem [] (przynajmniej w konfiguracji Release, w wersji Debug w implementacji Visual Studio występuje sprawdzenie za pomocą asercji). Jednak jej używanie również wymaga pewnej wiedzy i świadomości, nie tylko na temat dostępnych funkcji i koncepcji takich jak iterator, ale również implementacji wewnętrznej. Kontenery list, set i multiset, map i multimap dynamicznie alokują każdy element jako oddzielny obiekt w pamięci, co działa niekorzystnie na wydajność z opisanych już wyżej powodów. Natomiast std::vector przechowuje swoje elementy w ciągłym obszarze pamięci, jako zwykłą tablicę, więc możemy dla wygody używać tego kontenera zamiast dynamicznie alokowanych tablic, nie bojąc się o utratę wydajności (ponownie – w konfiguracji Release, ponieważ w konfiguracji Debug kod intensywnie używający STL cechuje dużo gorsza wydajność – właśnie ze względu na dodatkowe asercje). Nadal jednak można pewne rzeczy napisać lepiej, tak jak to zrobili programiści w firmie Electronic Arts tworząc bibliotekę EASTL – zamiennik STL zoptymalizowany z myślą o programowaniu gier, którego kod (choć niekompletny) jakiś czas temu udostępnili za darmo w Internecie.
Dobrze jest pozostać nieco nieufnym w optymalizacje przeprowadzane przez kompilator. Jako pierwszy przykład rozpatrzmy odwołanie pod przekazany wskaźnik. Wiemy, że słowo kluczowe volatile w C++ służy do zabezpieczenia jakiejś wartości przed optymalizacją, tak aby kompilator za każdym razem sięgał do źródłowego miejsca w pamięci zamiast zbuforować tą wartość w rejestrze procesora. Stosujemy je wtedy, kiedy taka wartość może się zmienić w sposób nieoczekiwany, na przykład z poziomu sprzętu albo innego wątku.
Jednak to tylko część historii. Nawet bez tego słowa kluczowego czasami kompilator nie może być pewny, że jakaś wartość nie zmieni się nieoczekiwanie i z tego powodu nie może przechować jej w rejestrze. Tak może się stać np. w funkcji pokazanej na Listingu 2. Ten prosty kod dodaje do każdego wektora w tablicy wartość przekazaną jako ostatni parametr. Ten stały wektor s mógłby być zachowany gdzieś w rejestrach albo na stosie. Jednak bez znajomości kontekstu (np. kiedy funkcja nie jest inline) kompilator nie może być pewnym, że wskaźnik s nie pokazuje na to samo miejsce w pamięci, co któryś z elementów tablicy tab tak że jedna z iteracji pętli zmieni jego wartość. Toteż musi za każdym razem sięgnąć do miejsca wskazanego przez s. Jest to tzw. aliasing wskaźników.
Listing 2. Aliasing wskaźników
void AddVectorToArray(vec3* tab, size_t n, const vec3* s)
{
    for(size_t i = 0; i < n; ++i)
        tab[i] += *s;
}
Pomogłoby tutaj jawne skopiowanie wektora s do zmiennej lokalnej lub jego przekazanie przez wartość albo zastosowanie niestandardowego słowa kluczowego __restrict, które informuje kompilator, że w bieżącym zakresie aliasing wskaźników nie zachodzi.
Innym przykładem może być definiowanie zmiennych wewnątrz pętli. Kompilator świetnie radzi sobie ze zmiennymi typów prostych, takich jak int, ale nie jest w stanie przemyśleć za nas wykorzystania bardziej skomplikowanych konstrukcji. Zróbmy eksperyment ze zmienną typu std::string. Listing 3 to pierwsza wersja kodu. Pętla 2 miliony razy buduje łańcuch z przedrostka, liczby i przyrostka, a na koniec zawsze kopiuje go gdzieś do zmiennej globalnej. Na moim komputerze wykonanie tego kodu zajmuje średnio 0,36 s.
Listing 3. Definicja zmiennej string wewnątrz pętli
for(int i = 0; i < 2000000; ++i)
{
    std::string s;

    s += "ITER_";

    char sz[16];
    itoa(i, sz, 10);
    s += sz;

    s += ".txt";

    memcpy(g_Buf, s.c_str(), s.length() + 1);
}
Wykonajmy teraz prostą optymalizację. W nowej wersji kodu na listingu 4 string będzie zdefiniowany przed pętlą i tylko czyszczony na początku każdego przebiegu wywołaniem metody clear. Ten kod wykonuje się u mnie średnio 0,27 s.
Listing 4. Definicja zmiennej string na zewnątrz pętli
std::string s;
for(int i = 0; i < 2000000; ++i)
{
    s.clear();

    s += "ITER_";

    char sz[16];
    itoa(i, sz, 10);
    s += sz;

    s += ".txt";

    memcpy(g_Buf, s.c_str(), s.length() + 1);
}
Wykonując prostą poprawkę – zmieniając 2 linijki w kodzie, a nie zmieniając zupełnie jego logiki, zyskaliśmy 25% czasu wykonania. Jak to możliwe? Tajemnica tkwi w budowie wewnętrznej klasy string z STL. W implementacji Visual C++ 2012, której użyłem, obiekt taki – podobnie jak vector – potrafi w razie potrzeby powiększać się, realokując wewnętrzną pamięć, ale nigdy się nie zmniejsza. Usuwanie jego elementów lub nawet kompletne jego wyczyszczenie powoduje tylko ustawienie bieżącej długości na 0, podczas gdy zaalokowany blok pamięci zostaje ten sam (aby naprawdę zwolnić pamięć kontenera, należy wykonać tzw. swap trick). Dzięki temu ponowne użycie obiektu, jeśli jego nowa zawartość nie będzie dłuższa od poprzedniej, nie wymaga żadnej alokacji pamięci. W poprzednim kodzie natomiast cały obiekt powstawał w każdym przebiegu pętli od nowa, musiał zaalokować potrzebną pamięć, a wraz z nawiasem zamykającym był niszczony i w swoim destruktorze musiał tą pamięć zwolnić.
Mimo wszystko kompilator wykonuje wiele sprytnych optymalizacji. Możemy je kontrolować za pomocą przełączników. Każdemu znany jest pewnie przełącznik odpowiedzialny za ogólny poziom optymalizacji – /O2. Jest on włączony domyślnie w kompilatorze Visual Studio w konfiguracji Release. Warto włączyć także kilka innych, wchodząc do opcji projektu do zakładki Configuration Properties > C/C++ (oczywiście wcześniej zapoznając się w dokumentacji z opisem tego, co każdy z nich powoduje i jakie będą tego konsekwencje):
Wielu osobom wydaje się, że owa mityczna „optymalizacja” polega na przepisywaniu wybranych procedur na trudny i nieczytelny asembler. Tymczasem dziś rzadko zachodzi taka potrzeba. Kompilatory dobrze radzą sobie z optymalizacją kodu na poziomie pojedynczych instrukcji. Warto jednak znać asembler na tyle, aby od czasu do czasu przejrzeć i zrozumieć kod wygenerowany przez kompilator.
Ci, którzy nie chcą, nie potrafią lub boją się zajmować wydajnością swojego kodu, często zasłaniają się cytatem Donalda Knutha, który jakoby powiedział, że „przedwczesna optymalizacja jest źródłem wszelkiego zła”. Tymczasem jego pełna wypowiedź brzmi: We should forget about small efficiencies, say about 97% of the time. Premature optimization is the root of all evil (Knuth, Donald (December 1974). „Structured Programming with go to Statements”. ACM Journal Computing Surveys 6 (4): 268) i dotyczyła po prostu czegoś, co autor zrobił na poprzedniej stronie, przyspieszając o 12% kod pętli za pomocą... instrukcji goto. Nie chodzi więc o to, że nie warto w ogóle przejmować się optymalizacją. O wydajności warto myśleć, pisząc kod zawsze – od projektowania aż po dobre nawyki dotyczące konstrukcji języka programowania.
Niektórzy twierdzą, że optymalizacja to coś, co robimy, kiedy program jest już napisany. Uruchamiamy wtedy profiler i znajdujemy funkcję, której wykonanie zabiera 30% całego czasu, a potem staramy się zoptymalizować jej kod. Czasami jednak może się okazać, że nie ma jednej czy kilku takich funkcji krytycznych dla wydajności – różne miejsca programu zabierają po mały procent czasu, a program jako całość działa wolno, bo jest ogólnie źle napisany. W nielepszej sytuacji znajdziemy się, jeśli odkryjemy, że zoptymalizowanie takiej czasochłonnej funkcji wymagałoby przeprojektowania struktur danych i przepisania na nowo dużej części programu. Dlatego warto dbać o wydajność naszego kodu w codziennej, programistycznej pracy.
W sieci
 English
 Polski